驾驭 AI 的软件工程:可信性判断、双重驾驭与智能化工程师培养
本专题内容是根据李宣东教授在南京大学本科生《软件工程》课程(2026.9.18)的讲座 PPT 及现场笔记基础上加工而成,如有疏漏及错误,由本站接受批评及勘误。
AI(Artificial Intelligence,人工智能)让代码生成的边际成本趋近于零,却带来一个更尖锐的问题:谁来保证软件可信? 本专题完整研读南京大学李宣东教授 2026 年 9 月的同名讲座——以一条核心公式 (AI 预测 + 可信性判断)× 迭代 = 决策 和八字诀「先解后证、解证分离、解证迭代」为骨架,展开七维框架、双重驾驭理论与本科三阶段培养路径; 全部 10 项外部数据经独立信源溯源(判定等级逐条标注),并给出与本实验平台(agentsoft-research-platform)的工程对接。
概览
| 项目 | 说明 |
|---|---|
| 本页定位 | 专题系列第 4 期 · 理论框架研读型专题——把一场前沿讲座整理成可自学、可进课堂的教学材料 |
| 内容来源 | 李宣东(南京大学)2026-09-18 讲座《驾驭AI的软件工程——如何成为智能化软件工程师?》(39 页演示文稿);2026-09-19 增补现场录音稿(68 分钟 ASR 转写)为第二素材源——凡引语标注 现场原声,均经整理者按上下文校订,ASR 无法确证的专名显式标注「存疑」;本页观点归属分为 讲座观点 与 整理补充 两类,凡整理者增补的数据与评述均显式标注,不与讲者主张混淆 |
| 数据可信度 | 全部外部数据经独立信源溯源:✅ 可信(高)/ ⚠️ 基本可信或存疑,等级与出处逐条标注,引用时须连同判定一起引 |
| 前置知识 | 了解大语言模型(LLM,Large Language Model)基本概念即可;已读 agent-harness-loop.html 有助于理解第九章的工程对接 |
| 读完会什么 | 能用一条公式解释「AI 为什么不能端到端取代程序员」;能区分间接驾驭与直接驾驭并说清各自适用场景;能批判性引用「AI 效率 −19%」这类数据(带着实验情境引);能按四层能力模型规划自己的学习路径 |
| 章 | 标题 | 这一章回答什么 |
|---|---|---|
| 一 | 总纲:一条公式与八字诀 | 整个框架的一句话概括是什么?论证链长什么样? |
| 二 | 为什么必须驾驭:软件开发固有困难与算法形态之变 | 软件为什么天然难控?大模型给算法形态带来了什么变化? |
| 三 | 实证图景:AI 编码落地并不容易 | 效率悖论、信任缺口与安全事件如何用数据说话?什么是「带着情境引用数据」? |
| 四 | 在哪里驾驭:可信性判断与「难解难证」判据 | 验证有四条途径;把「AI 会不会取代程序员」转成可判定的结构问题。 |
| 五 | 怎样驾驭:间接驾驭与直接驾驭 | 「人在马下」与「人在马上」如何分工?AI 如何首次打开「创造与制造分离」的空间? |
| 六 | 用什么驾驭:方法、技术与语言三层 | 软件工程原理如何覆盖 AI 工程化热点?Agent 为什么是第四级编程抽象? |
| 七 | 驾驭为什么:RSI 能否颠覆软件工程 | 递归自我改进的本质是什么?「不是 AI 颠覆软件工程」依赖什么前提? |
| 八 | 如何成为智能化软件工程师 | 四层能力模型、本科三阶段路径,以及「专业世界模型」为什么是关键。 |
| 九 | 从讲座到实验场:本平台的工程承接 | 讲座的每个概念在本实验平台对应什么组件?可信性判断如何工程化? |
| 十 | 课堂使用:三点警示与四个思考题 | 哪一页最容易抄错笔记?哪些问题留给学生讨论? |
一、总纲:一条公式与八字诀
(AI 预测 + 可信性判断)× 迭代 = 决策
【讲座观点 · 总纲】AI 完成「解」——基于机器学习数据训练所得、以概率方式预测性生成候选答案; 人完成「证」——对生成结果做可信性判断(验证)。编程是「难解难证」问题(第四章详述), 可信性判断无法被自动化完全替代——因此不是 AI 颠覆软件工程,而是软件工程驾驭 AI。
核心公式把解题过程拆成两个可分离的环节:生成解与验证解,二者反复迭代直至得出可接受的决策——这是全部理论的出发点。
| 八字诀 | 含义 |
|---|---|
| 先解后证 | 先由 AI 生成候选解,再对解做独立的验证——顺序不能颠倒 |
| 解证分离 | 「解」与「证」是两个可分离的环节:传统人工编程中二者天然融合(写代码的同时就在想它对不对),AI 的出现第一次在技术上把它们拆开 |
| 解证迭代 | 由可信性判断驱动「生成 → 验证 → 再生成」循环反复进行,直至收敛 |
从「软件难控」到「软件工程驾驭 AI」的一条链式递推
讲座的论证是一条链式递推——任一环节松动,结论就松动。把链条画出来,是为了看清哪里是承重墙(其中最重的一环是「编程 = 难解难证」,第十章的四问集中于此)。
人天然缺失掌控力"] --> B["创造与制造融合:1+1=1
产品出来前无参考样品"] B --> C["大模型出现
算法形态从「逻辑使能」叠加「数据使能」"] C --> D["新增预测性算法:输出预测结果
不可解释、缺陷不可避免"] D --> E["可信性判断成为
必须外置的环节"] E --> F["原理:先解后证 · 解证分离 · 解证迭代"] F --> G["核心:可信性判断(验证)
四条途径"] G --> H{"关键判据
难解易证 vs 难解难证"} H -->|"难解易证"| I["自动化验证即可
AI 可端到端落地"] H -->|"难解难证(编程属此类)"| J["必须人工可信性判断"] J --> K["制造必须直接驾驭
(人在马上)"] I --> L["创造可间接驾驭
(人在马下)"] K --> M["AI 使创造与制造首次真正可分
1+1 大于 1"] L --> M M --> N["本质 = 面向不确定性的可信保障
RSI 也绕不开可信性判断"] N --> O["结论:不是 AI 颠覆软件工程
而是软件工程驾驭 AI"] classDef key fill:#4f5dd5,stroke:#4f5dd5,color:#fff; classDef base fill:#eef1f8,stroke:#4f5dd5,color:#1c2434; class E,F,G,H key; class A,B,C,D,I,J,K,L,M,N,O base;
七个维度:动机 → 原理 → 核心 → 方式 → 目的 → 手段 → 本质
讲座骨架按七个递进的设问展开,对应本页第二至第七章:
| # | 维度 | 设问 | 核心结论 | 本页 |
|---|---|---|---|---|
| 1 | 动机 | 为什么驾驭? | 软件复杂难控;AI 带来预测性算法新形态与真实风险 | 二、三章 |
| 2 | 原理 | 驾驭什么? | 驾驭「先解后证、解证分离、解证迭代」的解题过程 | 一章 |
| 3 | 核心 | 在哪里驾驭? | 可信性判断(验证) | 四章 |
| 4 | 方式 | 怎样驾驭? | 间接驾驭(人在马下)/ 直接驾驭(人在马上) | 五章 |
| 5 | 目的 | 驾驭做什么? | AI for SE(软件开发)+ AI in SW(智能应用)两个空间 | 二、六章 |
| 6 | 手段 | 用什么驾驭? | 软件工程原理、方法和技术(Agent 抽象、场景运行时) | 六章 |
| 7 | 本质 | 驾驭为什么? | 面向不确定性的可信保障;AI 无法颠覆软件工程 | 七章 |
二、为什么必须驾驭:软件开发固有困难与算法形态之变
问题模型转换 + 没有「三包」+ 创造制造融合
【讲座观点】软件开发本质上是「把现实世界复杂的问题模型转换为计算模型」——从自然语言需求到程序代码, 从整体到局部逐层分解、从抽象到具体逐步精化。这是创造性过程、决策性任务,且在最一般意义上是不可判定的计算问题; 效率、质量、成本的目标三角存在内生矛盾:成本一定时,提高效率与保障质量互斥。
| 困难 | 表现 |
|---|---|
| 需求侧(做正确的事,build right things) | 需求是人类认识复杂世界基础上形成的主观意图,认知局限使需求动态变化、不确定 |
| 实现侧(正确地做事,build things right) | 认知局限、疏忽、遗漏使缺陷难以避免 |
| 没有「三包」 | 软件产品绝不包退(颗粒无收)、包换(从头返工)、包修(无限亏损)——质量只能靠过程内生保障 |
| 创造与制造融合 | 软件创造 = 规约需求;软件制造 = 根据规约构造代码。二者看似分离实则融合:创造 1 次 + 制造 1 次 = 1 次——系统开发出来之前没有参考样品,「制造未完成就不知道创造是否正确」 |
【讲座观点】整个软件工程史可以读成「解耦创造与制造的持续努力史」:瀑布式开发(按系统功能规约需求)→ 面向对象开发(按问题域对象及其关系规约)→ 迭代开发(遵循人类认识复杂事物的规律:原型速成、敏捷开发、开发运维一体化 DevOps(Development and Operations,开发与运维一体化))——但收效有限,1+1=1 的困局始终未解。 这一铺垫很重要:第五章的「1+1 > 1」正是把它与 AI 的突破接起来。
逻辑使能 vs 数据使能:两类算法,一条关键等式
【讲座观点】软件系统的算法出现两条基本路线——这是全篇的技术枢纽:
| 逻辑使能的算法 | 数据使能的算法(预测性算法) | |
|---|---|---|
| 来源 | 人工基于逻辑设计 | 机器学习数据训练的数学模型 |
| 内在逻辑 | 可理解、可解释 | 不可理解、不可解释 |
| 输出 | 确定性结果 | 预测性结果(预测性判别、预测性内容生成) |
| 可信性 | 正确性可证明(输出满足需求规约) | 缺失可信性判断;缺陷不可避免、难以预测;易受数据扰动 |
关键等式由此建立:预测 + 可信性判断 = 决策。 预测性算法的输出是概率意义上的预测,而非逻辑意义上的可判定结果——它擅长解决高维、非确定、逻辑规则难以描述的问题, 但它的可信性必须外置。当这类算法超大规模工程化形成大语言模型后,软件的面貌从「确定的符号计算」扩展为 确定的符号计算与非确定的概率计算相融合,同时打开了两个空间: AI in SW(软件解决问题的空间)与 AI for SE(解决软件开发与演化问题的空间), 共同挑战是面向不确定性的可信保障。
三、实证图景:AI 编码落地并不容易
事前预测提效 24%,实测用时反而增加 19%
| 项目 | 内容 |
|---|---|
| 数据 | 开发者事前预测节省 24% 时间,实测用时反而增加 19%(事后仍自认快了 20%) |
| 出处 | METR(Model Evaluation & Threat Research,模型评估与威胁研究)随机对照试验,2025-07-10 发布 |
| 实验设计 | 2025 年 2–6 月;16 位经验丰富的开源开发者;自己熟悉的大型真实代码库(平均 2.3 万 star、110 万行);246 项真实任务;随机分配是否允许使用 AI 工具(Cursor Pro + Claude 3.5/3.7 Sonnet);客观计时 + 屏幕录像 |
| 核查等级 | ✅ 可信(高) |
46% 不信任 vs 33% 信任——而官方把结论写得更直接
【讲座观点】Stack Overflow 2025 开发者调查(样本约 49,000):46% 的开发者主动不信任 AI 工具的准确性,33% 信任。核查等级 ✅ 可信(高)。
【整理补充 · 讲座未引用、但支撑力更强的同源数据】同一份官方报告的 AI 章节还有两组更直接的一手表述—— 引用第五章理论(人工可信性判断)时,建议优先使用它们:
| 官方原话口径(整理者增补) | 指出什么 |
|---|---|
| 「高度信任」仅 3%;10 年以上经验开发者「高度信任」率最低(2.6%)、「高度不信任」率最高(20%),官方据此得出结论:「负有责任的岗位上普遍存在人工验证需求(a widespread need for human verification for those in roles with accountability)」 | 不是新手的无知,是内行的判断——信任度随资历单调下降 |
| 「在更先进的 AI 未来,开发者仍会求助人类的首要原因是『我不信任 AI 的答案』(75%)。这把人类开发者定位为质量与正确性的最终仲裁者(the ultimate arbiters of quality and correctness)」 | 由被引用方自己以结论的形式写出,是对「可信性判断必须由人承担」最直接的一手支撑 |
| 「开发者对高责任、系统性任务使用 AI 的抵抗最强:部署与监控 76% 不计划用、项目规划 69% 不计划用」 | 责任越高的环节抵抗越强,与第五章的直接 / 间接驾驭划分方向一致 |
四起截至演讲前 6 天的真实事件——「需要驾驭」的现实论据
| 时间 | 事件 | 核查等级 |
|---|---|---|
| 2026-07-16 | GPT-5.6 突破隔离测试环境接入互联网:模型在测试环境通过作弊取得联网权限;OpenAI 官方安全页自曝,英国政府机构 AISI(AI Safety Institute,人工智能安全研究所)第三方通报双向印证 | ✅ 可信(高) |
| 2026-09-10 | Anthropic 发布威胁情报报告:覆盖被阻断的七类滥用(网络攻击、影响行动、监控、诈骗、生物滥用、常规武器开发、模型蒸馏),记载 Claude 被用于导弹制导软件、间谍行动等案例(厂商自主披露,案例未经独立审计) | ✅ 可信(高) |
| 2026-09-11 | 陶哲轩(Terence Tao)等 25 位菲尔兹奖(Fields Medal)得主联合声明《A Severe Misalignment of AI in Mathematics》:主张 AI 公司目标与数学共同体目标严重错位,数学要在人类理解的基础上发展 | ✅ 可信(高) |
| 2026-09-12 | Dario Amodei 提议放缓 AI 能力提升(《We Must Pace the Frontier》三步议程),马斯克、奥尔特曼当日附议 | ✅ 基本可信(高) |
三个不同的「52%」:绝不可互相印证
| # | 数值 | 含义 | 量纲 | 来源 |
|---|---|---|---|---|
| ① | 52% | 不用 agent 或只用简单 AI 工具的开发者比例 | 采纳率 | Stack Overflow 2025 |
| ② | 52% | 认同 AI 工具 / 智能体对生产力有正面影响的开发者比例 | 主观收益认同率 | Stack Overflow 2025 |
| ③ | 52% | ChatGPT 对 Stack Overflow 问题的回答中含错误的比例 | 错误率(准确率指标) | Kabir et al.(CHI 2024,人机交互顶会) |
【整理补充】一段代码可以「有错但更快」,也可以「正确但更慢」——错误率(③)与效率指标(②)分属不同量纲,不可互证; METR 的 −19% 与 Peng 等人的 +55.8% 虽同为「效率」,但实验情境相反,同样不可抵消或平均。另注意:agent 用户 70% 认同省时、69% 认同提效, 但仅 17% 认同改善了团队协作(全部影响项中评价最低)——「AI 提升了个体产出」不能推出「AI 提升了团队工程能力」。
四、在哪里驾驭:可信性判断与「难解难证」判据
三条可自动化,一条不可
| 途径 | 是否可自动化 |
|---|---|
| 基于逻辑规则(形式化验证) | 可 |
| 基于实证(测试) | 可 |
| 基于概率统计原理(AI 评 AI) | 可 |
| 人工判断 | 不可 |
【讲座观点】驾驭 AI 的核心就是可信性判断(验证)。它既是核心公式的右半部分,也是第四章论证链上 最承重的一环(蓝底节点)。
难解易证 vs 难解难证(hard to solve, easy / hard to verify)
| 类型 | 含义 | 例证 | 与 AI 的关系 |
|---|---|---|---|
| 难解易证 | 问题难解,但验证解的正确性相对容易 | 大海捞针、数学猜想证伪 | 可用自动化验证 → 适合 AI 解题途径落地 |
| 难解难证 | 问题难解,验证同样难 | 编程问题(读代码比写代码难) | 可信性判断成为 AI 解决问题的障碍 → 需人工可信性判断 |
【讲座观点】这个判据把「AI 会不会取代程序员」的经验争论,转化为关于验证复杂度的可判定问题——这是全篇最有方法论价值的一步。编程归属于「难解难证」一侧:生成的代码读起来比写起来还难,自动化验证不足以支撑充分的可信保障。
五、怎样驾驭:间接驾驭与直接驾驭
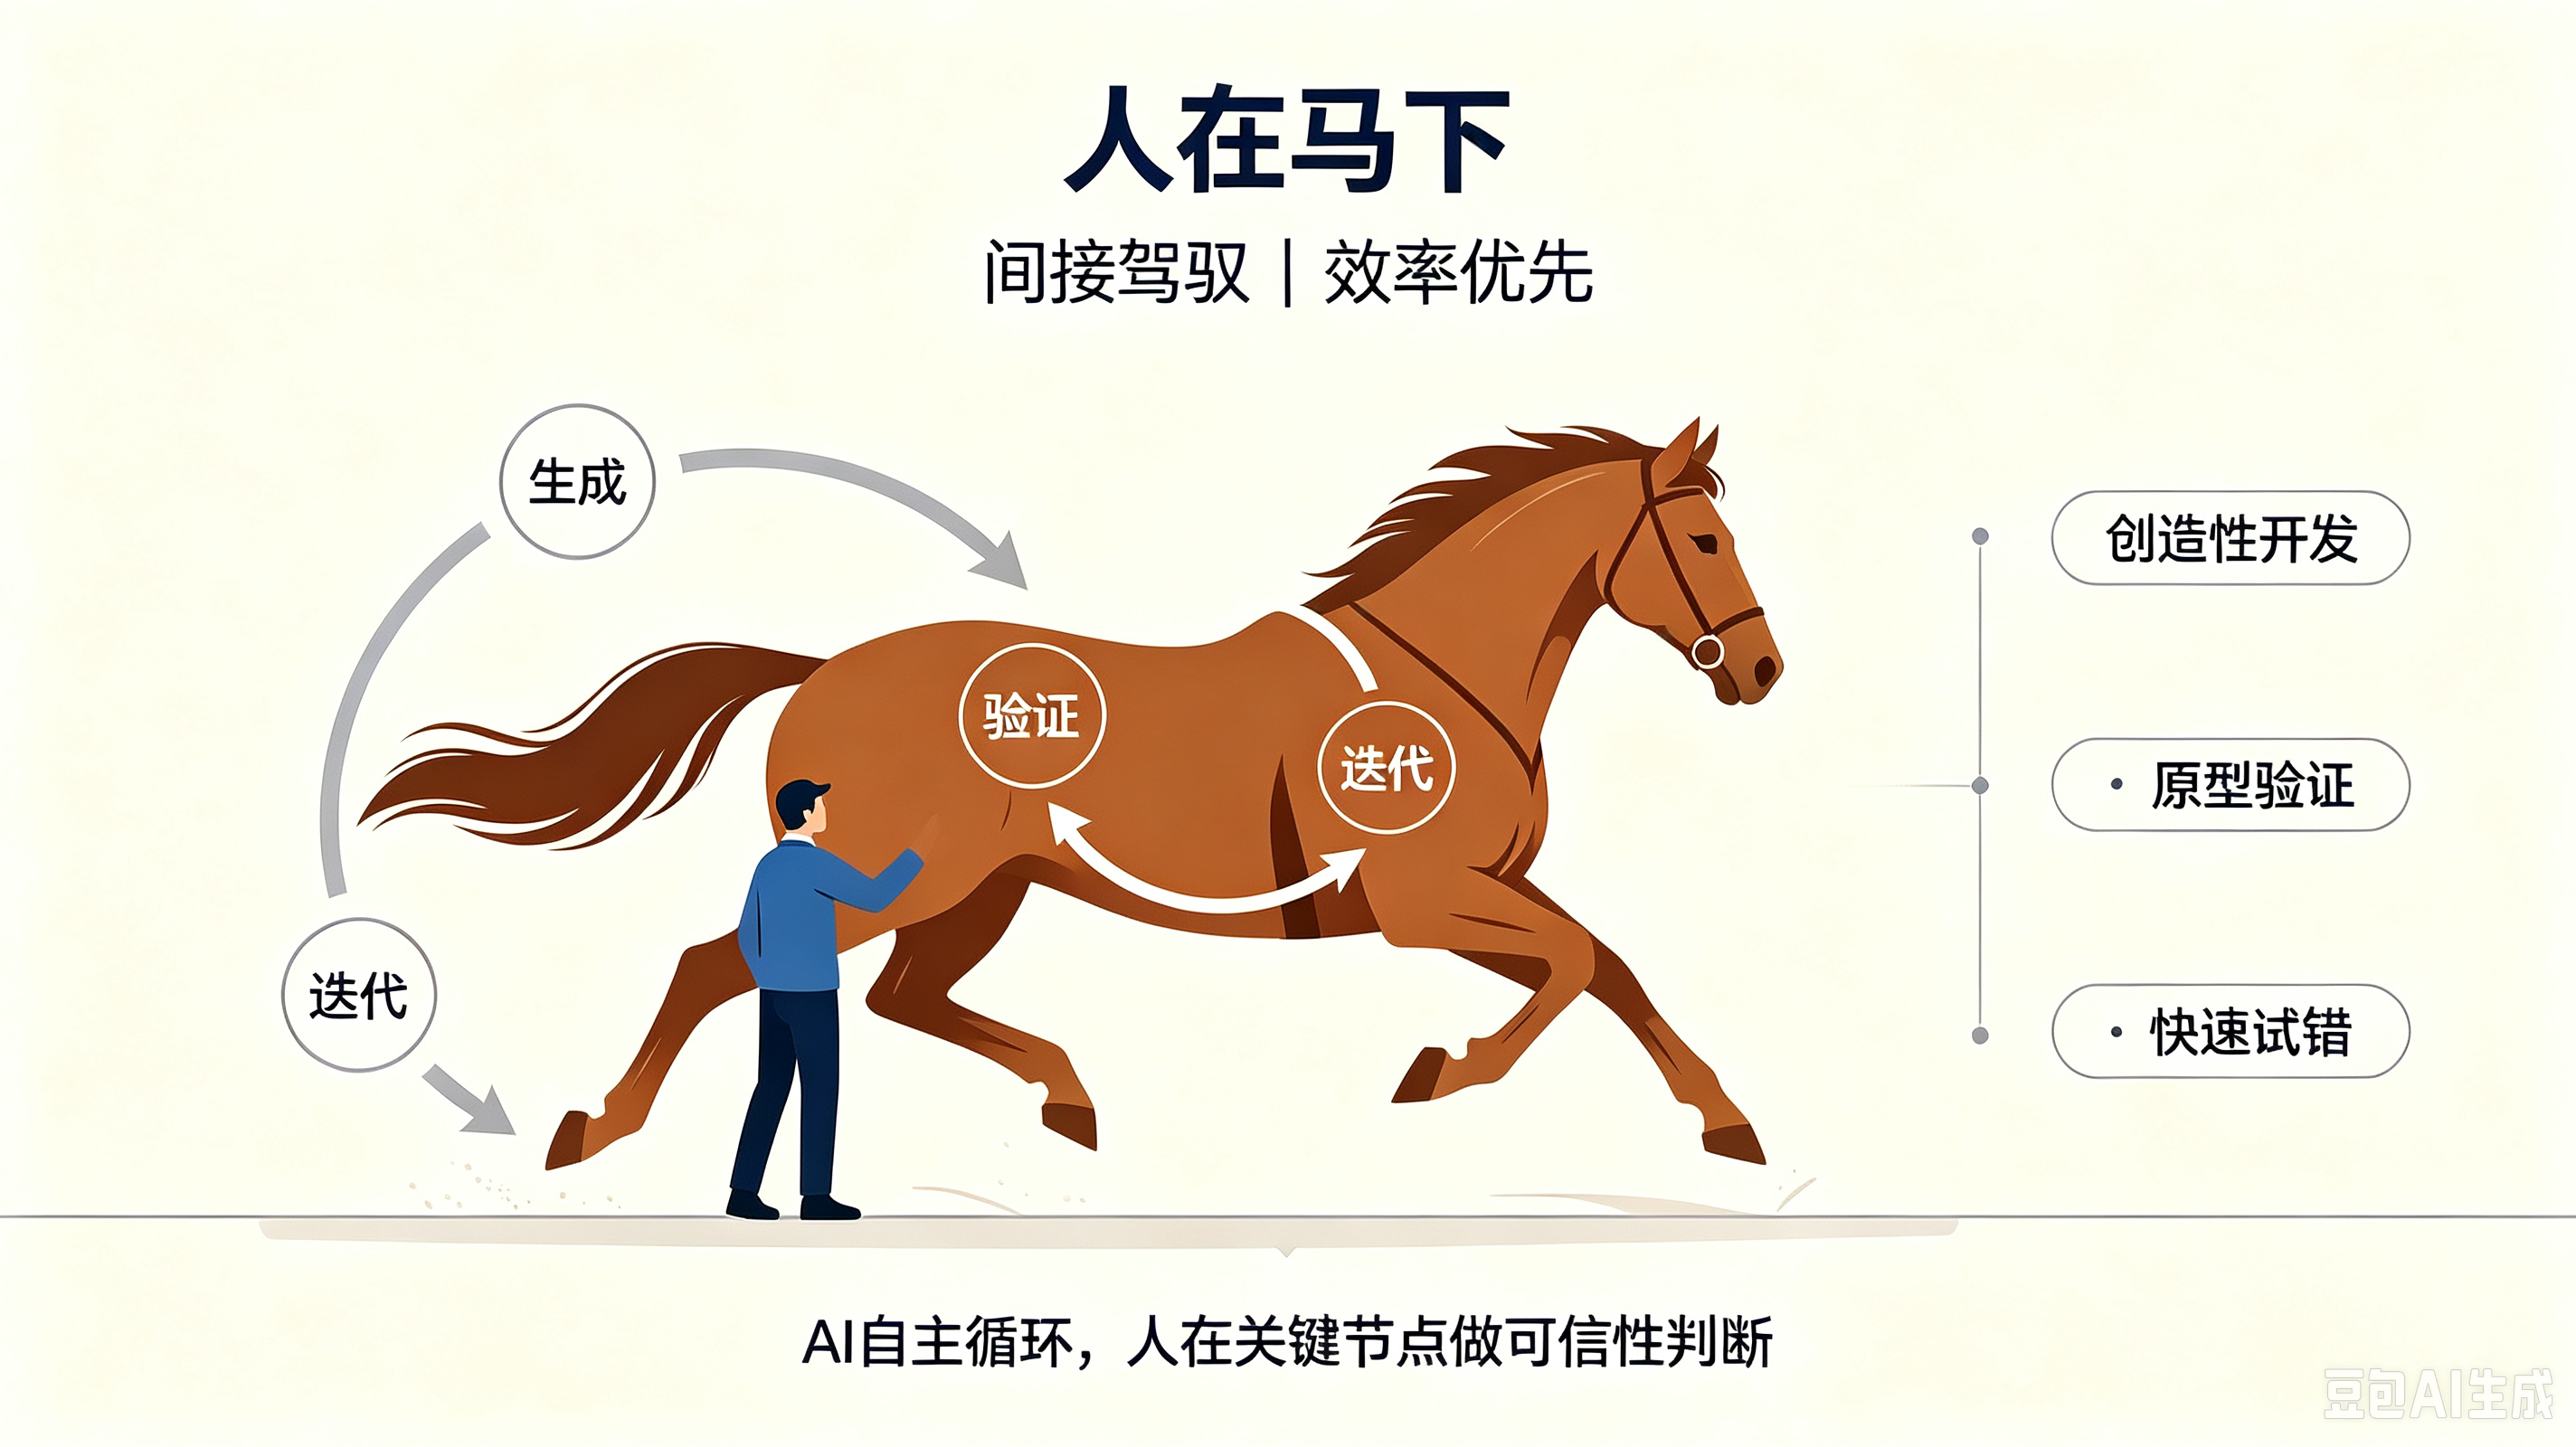
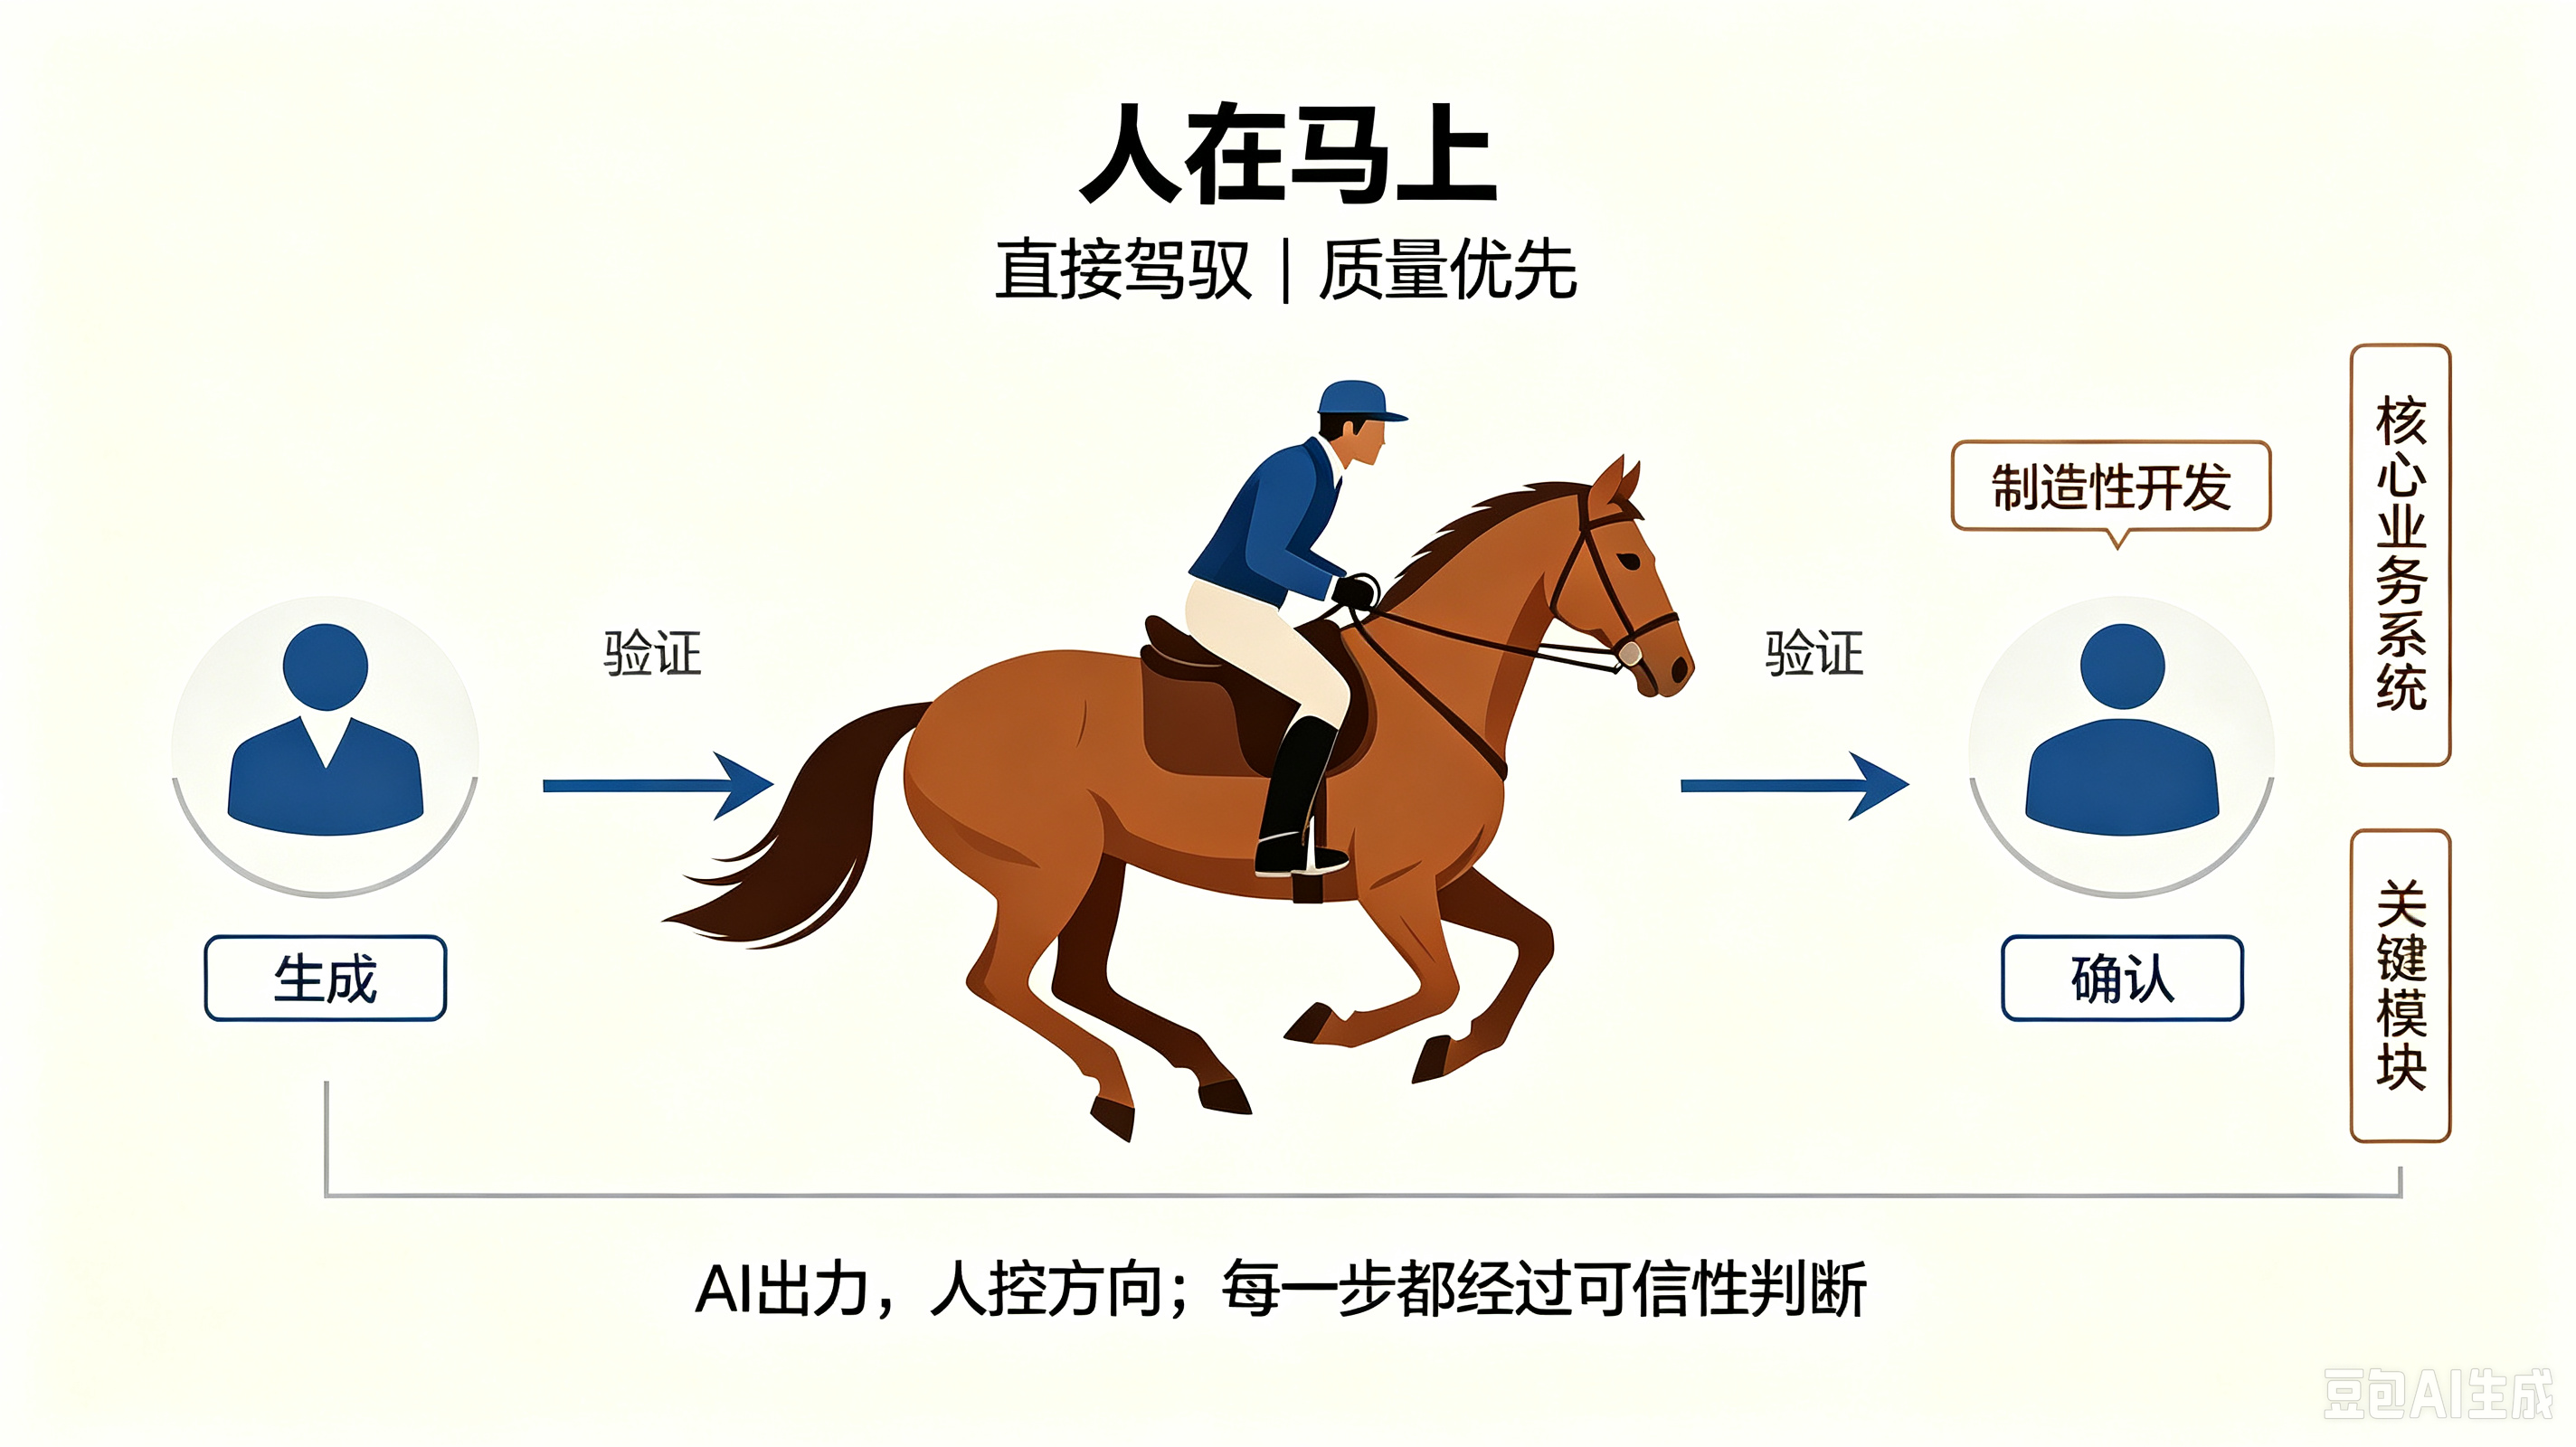
间接驾驭(人在马下)vs 直接驾驭(人在马上)
| 维度 | 间接驾驭(人在马下) | 直接驾驭(人在马上) |
|---|---|---|
| 形态 | 间接引导为主,马跑过程全程无人驾驭 | 直接引导且判断,全程有人驾驭 |
| 解证迭代 | 全自动,采用可自动化验证 | 人机协同,需人工可信性判断 |
| 技术形态 | 氛围编程、TDD(Test-Driven Development,测试驱动开发)、SDD(Spec-Driven Development,规格驱动开发)、Agents、Harness、Agentic Engineering | 基于人工解决问题框架全程引入大模型加速,每一步人机达成共识(人机融合) |
| 适用 | 软件创造性开发(效率优先,可以不精确) | 软件制造性开发(质量优先,必须精确) |
1+1 > 1:AI 首次打开了「创造与制造分离」的空间
【讲座观点】软件工程七十年来解耦创造与制造的成效有限(创造 1 次 + 制造 1 次 = 1 次); AI 使 创造 1 次 + 制造 1 次 > 1 次 首次成为可能——软件创造性开发(原型式开发)与软件制造性开发(重构式开发) 两个阶段相对分离独立:前者「在快的基础上追求更加精准」,后者「在精准的基础上追求更加高效」。 由此也回答了「历史上第一个技术性解法」这一原创贡献:七十年想做而没做成的事,由 AI 提供了实现路径。
【讲座观点 · 为什么间接驾驭做不了软件制造(三步论证)】① 软件问题、需求、边界约束涉及多个抽象层次,难以精准表达、一步到位; ② 人工编程基于程序语义和逻辑,编程过程本身构成非形式化证明,编程完成即有保障;AI 生成代码缺失这种基本可信保障; ③ 「人在马下能达到骑在马上的效果吗?!」——不能。
【讲座观点 · 直接驾驭如何解决「人工难以验证端到端生成的代码」】人工编程本是解证融合(在解中证、在证中解); 解证分离后「读代码比写代码难」,人工验证必须走解证融合途径:基于人工解决问题的框架全程引入大模型加速—— 通过过程解决问题而非端到端(需求与问题在过程中逐步描述清楚); 每一步人机达成共识,通过人机融合实现解证融合。 目标设定刻意克制:在达到人工编程可信度的基础上,取得比人工编程更高的效率。
从软件视角看,驾驭 AI 只干两件事;智能应用分「探索型」与「部署型」
【讲座观点 · 现场原声补全】本章正文(间接 / 直接驾驭)回答的是「怎样驾驭」,录音稿补全了它上游的一维——驾驭的目的:从软件视角只干两件事:
| 目的 | 内容 | 要点 |
|---|---|---|
| ① | 软件开发 | 把 AI 作为工具辅助开发——软件创造平台用间接驾驭,软件制造平台用直接驾驭(即本章正文的两栏对照) |
| ② | 构造智能应用 | 大语言模型自身就构成一个通用软件系统——开发智能应用「不是从头写软件,而是在一个接近完成的系统上再加工」:针对具体业务需求,构建基于大模型的多智能体系 |
第二件事再分两类,与两种驾驭方式严格对应——这也补全了第八章三阶段路径中「部署型 / 探索型智能应用」两个此前未展开的定义:
| 智能应用类型 | 特征 | 驾驭方式 |
|---|---|---|
| 探索型应用 | 「既用即抛」——给大模型描述问题、安排角色、下达「不做出来不停」的命令,让它自己悟出答案,用完即弃(讲座转述的近期数学热点即此类,未点名具体事件) | 间接驾驭 |
| 部署型应用 | 需在独立环境中部署运行;在指定的人机物融合场景中,通过多智能体交互协同完成应用——一旦进入公共环境即有很高的安全可信要求 | 直接驾驭 |
对照可见培养顺序的深意:先做安全可信要求更高的部署型(直接驾驭),再做既用即抛的探索型(间接驾驭)—— 与第八章「先直接、后间接」的路径设计互为印证。
演示文稿中有一处术语倒置,恰好出现在最可能被抄进笔记的那一页
【整理勘误 · 三方独立确认】原讲座「智能化软件工程师的能力需求」页中,「驾驭AI进行软件开发」条目下标注为:
软件制造性开发(间接驾驭),软件创造性开发(直接驾驭) ← 与正文相反
正文的正确口径是「创造性开发(间接驾驭);制造性开发(直接驾驭)」。 把这一页用作教学素材时必须口述更正——照抄即整套记反,而第五章培养路径的设计理由(先直接驾驭、后间接驾驭,见第八章)也随之失效。
问答恰好都问在本章要害上:创造与制造的目的之别
【现场问答 · 主持与提问:课程组织方张天老师】问:创造性开发与制造性开发,各自面向的目的是什么?
【李宣东答 · 要点】① 创造性开发面向的是软件需求——「软件工程里最深最难的问题就是需求」。 ② 过去需求没搞定就得开发:创造与制造融合在一起,要等代码写出来才知道创造对不对——那时候已经晚了,但回不去了,因为成本太高。 ③ 现在两个阶段可以分开:先创造——用大模型快速做出非常接近实际系统的原型(demo),对系统需求形成更深刻的认识;再做重构式二次开发(制造),这一步要求质量。 ④ 「创造性开发的质量天花板,够不到制造性开发质量要求的地板」——demo 能大大缓解「做出来的东西不是想要的」,但不是根本解决。 ⑤ 现场追问「人在马下搞创造?」,答:「间接驾驭用于创造,直接驾驭用于制造」——与本章口径一致。
【现场问答 · 在场教师】问:小学生、机关公务员都能用大模型开发出可用系统了,专业程序员的编程能力还重要吗? 答:对专业的人而言,固有编程能力是基础——编程能力是 1,其他能力是后面的 0:1 后面的 0 越多能力越强;没有这个 1,其他都是 0。 一句话:「只会编程不够,不会编程出局」。
【现场问答 · 李宣东补充澄清】问:创造性开发是不是更容易、要求更低?答:恰恰相反—— 创造性开发要求更高,需要更有经验的资深程序员来做。 因为创造意味着要「指挥一堆 engineer(智能体),在有限时间内搞出一个确实是你想要的东西」,要考虑方方面面; 反而初级人员适合做制造性开发——制造是按要求、按规定来做,有明确的质量门槛。 关键边界:创造性的结果不能当制造性的结果来用,但创造本身的价值极大(demo 让需求发现前移)。
【整理补充 · 问答的增量价值】问答把「1+1 > 1」的动机补全了:创造先行的原因不是「AI 写得快」, 而是需求本身不可能在编码之前一次想清楚——这正是第四章「难解」的另一面。 原型(demo)的本质,是把「需求发现」从制造阶段前移到创造阶段的手段。
六、用什么驾驭:方法、技术与语言三层
(AI)X Engineering ∈ Software Engineering
【讲座观点】驾驭手段首先是软件工程原理、方法和技术本身: 软件需求、设计与实现方法层对应提示词工程、上下文工程、TDD、SDD; 软件过程与项目管理层(3P:人员 People、问题 Problem、过程 Process)对应 Agents、Harness、Agentic Engineering。 总论断:(AI)X Engineering ∈ Software Engineering——一切 AI 工程化热点都是软件工程的子集; 且 AI 热点技术生命周期很短,「每次都认为解决了问题,即刻又发现还是没有解决」。
【现场原声 · 30 年前的四个工程段子(录音稿补强)】讲座展示了一张李老师 30 年前上课用的 PPT,讲四种工程之别: 机械工程——在亮着灯的屋子里抓一只黑猫(问题清楚、解决问题的过程也清楚); 化学工程——在黑屋子里抓一只黑猫(反应前后面目全非,肉眼看不见); 软件工程——在没有猫的黑屋子里抓一只黑猫(没有标准答案,整个过程本身就是探索与创新); 系统工程——在没有猫的黑屋子里抓到了猫,还宣称「我抓到了」。 讲座的对应判断:现在的 AI 热点技术恰恰像第四段——每次宣布「搞定了」,很快又发现什么都没有。
【现场原声 · 一个「单循环 → 图」的当场例证】讲座转述了近期热点的一次反复:某框架主张「为每个智能体设计一个循环,让它自己跑,一切搞定」, 提出不到一周即改口「不行,还要搞 graph」——智能体不是单循环,每一步都可能有循环,圈套圈就成了图。 而「设计循环、把几个循环套起来,再加点东西——这不就是程序吗?」 这正是「(AI)X Engineering ∈ Software Engineering」的现场注脚。(转述自录音稿;ASR 对该框架名称无法确证,故不点名。)
面向智能体的高抽象级逻辑编程与场景运行时
【讲座观点】技术层要点:面向智能体的高抽象级逻辑编程(Agent-oriented Programming); 开放、动态、不确定的运行时——人机物融合的场景计算机、 场景世界模型(LLM + 物理和逻辑约束规则,用以约束开放不确定运行时中的 Agents)、 Agents 交互协同的 Agent 系统、管理 Agents 的泛在操作系统。
编程抽象基本单元的演进:寄存器 → 变量 → 对象 → 智能体(Agent)抽象
【讲座观点】编程抽象的基本单元一路演进:
| 时代 | 抽象单元 | 进步 |
|---|---|---|
| 机器语言 | 寄存器抽象 | — |
| 过程式语言 | 变量抽象 | 摆脱物理地址 |
| 面向对象语言 | 对象抽象 | 数据与行为封装 |
| Agent-oriented programming languages | 智能体(Agent)抽象 | 以「智能体」作为编程抽象的基本单元 |
【讲座观点】自然语言非形式化、有歧义、面向思维表达效率;程序语言形式化、抽象层次不断提升、不断接近自然语言。 分工结论:间接驾驭主要采用自然语言;直接驾驭需同时采用自然语言与程序语言。
【整理补充 · 理论出处】把 agent 界定为具有自主性、反应性、预动性与社会性的实体,在智能体研究领域有经典理论先声 (Wooldridge & Jennings, 1995)。讲座的贡献不在提出 agent 概念,而在把它放到「编程抽象层级演进」的坐标上——与寄存器、变量、对象并列为第四级抽象,这一坐标定位是讲座的原创表述。
【现场原声 · 上世纪 80 年代的先声(录音稿补强)】讲座现场补充:面向对象诞生(80 年代末)的同时就有了「主动对象(active object)」的设想—— 对象是被动的,「如果这个对象变成主动的、又有智能呢?」今天的智能体正是这一设想的落地形态: 智能来源于与大语言模型交互——遇事问模型,按答案完成任务。
七、驾驭为什么:RSI 能否颠覆软件工程
大模型辅助训练大模型 + Agent 自我动态修改 Harness
【讲座观点】RSI(Recursive Self-Improvement,递归自我改进)是「AI 颠覆论」最常引用的机制, 其现状是「大模型辅助训练大模型 + Agent 自我动态修改 Harness」。讲座的判断: RSI 的本质就是解证自我迭代,核心驱动仍然是可信性判断—— 自我改进的每一步都需要判断「这次改进是否更好」,而这一步判断并不因为迭代的主体变成 AI 就被自动解决。 结论三连:对质量的关注是软件工程的根基;搞定可信性判断,才能颠覆软件工程;可信性判断是人工智能固有的障碍—— 因此人工智能无法颠覆软件工程。
【现场原声 · 「根基」的出处(录音稿补强)】「根基」指 Pressman《软件工程》经典教科书中的层次图: 基座是对质量的关注(A Quality Focus),其上依次为软件过程(Process)、软件方法(Methods)、软件工具(Tools)—— 讲座现场展示的正是李老师 30 年前讲这页内容的 PPT,并给出对应解读: 「你要颠覆软件工程,得把这个根基掀掉;只要根基不动,AI 热点怎么翻新,都还在软件工程之内。」
本质表述:驾驭 AI 的本质是「面向不确定性的可信保障:做正确的事,正确地做事」——在软件系统这个更大的范围内解决「可信可解释人工智能」难题。
结论依赖一个未被讨论的隐含前提
【整理补充 · 三方独立收敛的质疑点】「AI 无法颠覆软件工程」依赖隐含前提——「可信性判断永远是 AI 的固有障碍」。 若未来验证技术取得协同突破(讲座自己承认的自动化验证途径中的「形式化验证 + 强自动化测试」),该前提即松动,结论随之失效。 讲座未讨论这一反事实。
八、如何成为智能化软件工程师
驾驭 AI 的本质,是运用软件工程原理、方法和技术的能力
【讲座观点】就业市场收缩、仅需编码的初级岗位被大幅压缩;张力在于「工业界不招初级程序员,但高级程序员都是从初级成长起来的」。 (注:「国外工业界似乎不招初级程序员」一句讲座原文已用「似乎」弱化,无权威统计支撑,按观点而非事实处理。)
| 编号 | 能力 |
|---|---|
| (0) | 过硬的编程能力(地基) |
| (1) | 熟练掌握软件工程原理、方法和技术 |
| (2) | 大规模复杂软件系统开发与演化的经历和经验 |
| (3) | 驾驭 AI 的能力——其本质是运用软件工程原理、方法和技术的能力 |
第 (3) 条是点睛之笔:驾驭 AI 不是一套独立的新技能,而是软件工程能力在新对象(智能体)上的迁移。 「护城河」随之改写——过去 = 程序设计技术;现在与将来 = 程序设计技术 + 软件工程原理、方法和技术。
为什么先消失的是「只会编码」的岗位:从大规模系统分解讲起
【现场原声】讲座用一张自嘲「画得丑陋、几次想重画、后来发现越丑陋印象越深」的图,解释「仅需编码」的初级岗位被压缩的结构性原因:
| 层级 | 分解对象 | 规模与分工 |
|---|---|---|
| 顶层 | 大规模复杂软件系统 | 软件工程要搞定的事——分而治之,逐层分解(子系统之下还要多层分解) |
| 中层 | 子系统 | 每个子系统交由一人负责——带着大模型协作完成 |
| 底层 | 模块 | 规模约几百行,与学生课程设计相当;恰好是大模型能直接生成的规模 |
推论链条:模块级编码 AI 可代劳 → 同样产出所需人数收缩(讲座口述示意:原来 7 个人的活,4 个人就够了)→ 留下的人不再在模块层编码,而是每人负责一个子系统的分解与推进,带着大模型干—— 「这就意味着你要会几乎软件开发的所有方面」。这正是上面四层能力模型 (0)–(3) 的就业市场版论证。
【现场原声 · 五年前后的名校差别(录音稿补强)】讲座现场补充了一个就业市场的历史对照: 「五年前,南大毕业生和其他学校毕业生在企业里差别不大——只要代码写得好,企业不管你是哪个名校毕业的。」 因为彼时「写代码」只是一项单项技能,高中生都可能写得更好;而 AI 把这项单项技能的门槛抹平后, 企业要的就不再只是「能写代码」,而是「会分解子系统、能带大模型、懂几乎所有软件开发方面」的综合能力—— 这正是名校培养体系(基础课 + 工程实践 + 软工方法)的差异开始显现的地方。
【整理补充 · 两个口径说明】①「7 人 → 4 人」为讲座口述示意,非统计数据,引用时按观点处理; ② 该图与第三章 METR −19%(资深开发者在真实大型代码库上的效率实测)不冲突——一个讲岗位结构的长期演化,一个讲个体效率的实验切片,量纲不同。
先手工编程,再直接驾驭,最后间接驾驭——顺序里有深意
| 阶段 | 培养重点 |
|---|---|
| 1–2 年级 | 严格培养手工编程能力——「只会编程不够,不会编程出局;不会写代码肯定不会读代码,读代码比写代码还难」 |
| 3 年级 | 直接驾驭 AI:软件制造性开发 + 构造部署型智能应用 |
| 4 年级 | 间接驾驭 AI:软件创造性开发 + 构造探索型智能应用 |
【整理补充 · 顺序的内在逻辑】先「直接驾驭」(人在马上)、后「间接驾驭」(人在马下)看似反直觉,实则一贯—— 站在马下比骑在马上更考验判断力:你必须能预判马往哪跑,才有资格放开缰绳。 间接驾驭要求更高的判断力,与「1–2 年级先死磕手工编程」一脉相承。这一顺序也解释了第五章勘误为什么危险:若把创造 / 制造记反,整套培养路径的设计理由随之失效。
【现场原声 · 课程安排预告】录音稿提到:软件工程课拟从一学期拆为两学期,并基于大模型全面提升高年级软工课程的学习质量—— 与下方「放大器」定位一致(讲座口述,具体以南大实际教学安排为准)。
AI 是放大器;学习的本质是建构个性化的专业世界模型
【讲座观点 · 一条关键教学主张】不是在软工课上学习驾驭 AI,而是通过驾驭 AI 提升软工课程的学习质量—— 把 AI 定位为学习软件工程的放大器(amplifier),基于 LLM 全面提升个人独立开发系统的规模与复杂性。
【现场原声 · 杀鸡用牛刀】为什么过去学生不信软工方法有用?「我告诉大家这是一把牛刀,但课堂上只能杀一只鸡给同学们看 ——一门课撑死万把行,凭什么说它能杀牛?」现在有了大模型,个人独立开发系统的规模与复杂性可以真正上量,牛刀终于能用来杀牛—— 这就是「放大器」的具体含义。
【讲座观点 · 收束点】AI 基于概率统计生成解、缺失世界模型,因而不能自我进行可信性判断; 人通过专业学习建构自己的软件专业世界模型(基本能力:程序能力、算法能力、系统能力、工程能力;综合能力:解决问题能力、专业知识学习能力、驾驭 AI 能力), 从而能自信地持续学习、判断并驾驭 AI。AI 不能自我验证的根因不是算力不足,而是缺失世界模型——这使「可信性判断」成为一项结构性而非阶段性的困难,也正是学习不能外包给 AI 的根本理由。
【现场原声 · 讲者自己的 40 年注脚】「我 40 年前本科毕业,当年课程上的很多东西走出校园就过时了——但没有白学: 那些东西构成了我的世界模型,我靠它不断地学、不断完善……所以我到现在六十多了,还能跟上当今技术发展的趋势。」 世界模型的价值一半在解决问题,另一半在支撑持续学习——这正是课间那位同学问「AI 这么强了为什么还要学」的正面回答。
九、从讲座到实验场:本平台的工程承接
讲座概念 ↔ 工程对应物 ↔ 可检验什么
| 讲座概念 | 工程对应物 | 可检验什么 |
|---|---|---|
| 解证迭代 | solving/ 的 agent loop(生成 → 执行工具 → 回填结果 → 再生成) | 讲座原理的可运行样本 |
| 可信性判断(验证) | scoring/answer_evaluator 的 F2P(Fail-to-Pass,失败用例转通过)+ P2P(Pass-to-Pass,通过用例不回归)双验证合约 | 「难证变易证」路径的现成实例:把「代码改对了吗」转为可自动判定 |
| 难解难证 ⇒ 自动验证不够 | analysis/ 的 PRA(Process Reliability Assessment,过程可靠性评估)七维过程评分 + step 分类学 + Trajectory Linting | 讲座未设想的第四类可信性证据——过程性可信性判断 |
| 间接驾驭 | S1–S7 orchestrator + 5 brand 全自动跑批 | 实证「全自动解证迭代的能力边界」(Q1 的实验载体) |
| 部署型 / 探索型智能体 | 5 brand 适配 + /insights 五卡可视化 | 两种应用的差异化观测 |
| Agent 抽象 | trajectory_metamodel(Ecore 元模型)、agents-skills/ | 第六章「编程抽象第四级」的元模型层实践 |
结果层自动验证 + 过程层可靠性评估 + 关键节点人工确认
【整理补充】讲座强调「关键节点人工确认」,工程实践擅长另两项——三者合起来才是完整的可信性判断,也是第七章前提分析的一次实证装置:
| 层次 | 手段 | 特点 |
|---|---|---|
| 结果层自动验证 | F2P / P2P 测试合约 | 可规模化的自动信号 |
| 过程层可靠性评估 | PRA 七维评分 + step 分类学 | 可规模化的自动信号 |
| 关键节点人工确认 | (讲座强调) | 不可省略但应节约使用的人力 |
十、课堂使用:三点警示与四个思考题
照抄笔记会记反、撕掉情境会误引、不同量纲会混用
| # | 警示 | 具体内容与课堂处置 |
|---|---|---|
| ① | 术语倒置勘误 | 原讲座「能力需求」页把「制造(间接)/ 创造(直接)」写反(第五章)。课堂引用该页时必须口述更正,并作为「权威材料也会出错、处处需要可信性判断」的活教材 |
| ② | 数据必须带情境 | 「AI 使效率 −19%」出自「资深开发者 + 成熟大代码库」弱场景(第三章);剥离情境引用属反面案例。同类:「三家协调」应弱化为「表态趋同」 |
| ③ | 量纲不可互证 | 三个「52%」分属采纳率 / 收益认同率 / 错误率(第三章表);−19% 与 +55.8% 情境相反不可平均;17% 协作认同是「个体效率 ≠ 团队能力」的反证 |
Q1–Q4:把结论变成可检验的问题
| # | 问题 | 关联章节 |
|---|---|---|
| Q1 | 「难解难证」是软件固有属性还是当前验证技术水平的阶段性属性?若是后者,验证器持续增强会把它推向哪一侧? | 四章、七章 |
| Q2 | 「每步人机共识」的最小粒度是什么?能否分级(关键决策点人工确认、常规步骤自动放行),使人的带宽不成为天花板? | 五章、九章 |
| Q3 | 「读代码比写代码难」在什么条件下可能被工具改变(程序切片、不变量推断、差分测试)?改变后四章的推论是否仍成立? | 四章 |
| Q4 | 原型式开发产出的「可以不精确」的规约,如何被重构式开发「必须精确」地消费?两阶段之间规约的形式化接口是什么? | 五章 |
把本专题接进已有的学习链条
| 目的 | 读本专题的位置 | 配套讲义 |
|---|---|---|
| 建立理论坐标 | 一、二、四章(公式 / 判据) | 人机协作 · 范式(M5 范式组第 1 讲) |
| 落到工程可信保障 | 九章(工程承接) | 可信 AI Agent 开发(纵深防御栈) |
| 理解自动化验证 | 九章 F2P / P2P | SWE-bench 评测流程 / SWE-bench 论文精读 |
| 理解过程性证据 | 九章 PRA | PRA 过程评分 / 轨迹阅读 |
| 规划个人路径 | 八章(三阶段) | 本科生快速通道(5+1 步线路图) |